Нейросеть поглупела после релиза? Прогнал одну задачу 70 раз
Через неделю после выхода модели в ленте пишут «её понерфили». Я повторил свою проверку и нашёл, что меняет ответ сильнее модели: настройки и одна строка в задании.
Сам Решу
4 октября 2026 г. · 6 мин чтения
Содержание
«Приносим извинения за повреждённый плед и отсутствие ответа на сообщения. Пожалуйста, оформите заявку на возврат через Wildberries. С уважением, „Домашний уют“».
Плед, на который жалуется покупательница, называется Sleepy Cloud. Магазин «Домашний уют» такой не продаёт. Модель извинилась за чужой брак и подписалась именем магазина. Это GPT-6.1 Sol, сегодня утром, шестой ответ из десяти с одними и теми же настройками.
Неделю назад я проверял эту модель на пяти задачах селлера и написал, что новая Sol заметила чужой бренд в одном случае из двух, а предыдущая версия не заметила ни разу. Вывод получился аккуратный: новая версия лучше старой, флагман лучше обеих.
Сегодня я прогнал ту же задачу по десять раз. Предыдущая Sol заметила подвох в пяти случаях из десяти, новая в четырёх. Мой недельный вывод был результатом двух бросков монетки.
Откуда берётся «её понерфили»
Через неделю-две после каждого громкого релиза лента наполняется одними и теми же постами. «Модель сегодня ведёт себя как другая: бросает задачи, пропускает шаги, говорит, что сделала то, чего не делала». «В первые дни была гениальной, теперь полдня исправляю за ней то, что она понимала с полуслова». «Обидно, через две недели её понерфят». Последний пост написан через три дня после релиза, заранее.
На этой неделе на Hacker News в топ вышел проект, который каждый день гоняет одну модель Anthropic на замороженном наборе задач и ждёт, когда её результат упадёт. Первый вывод его автор обещает не раньше 24 октября: десять дней ушло только на то, чтобы понять, какой у модели обычный разброс.
Иногда модели и правда становятся хуже. Anthropic в 2025 году публично разбирала три сбоя в своей инфраструктуре: часть запросов уходила не на те серверы, у части портилась генерация. Ответы Claude были хуже неделями, жалобы в ленте шли всё это время, а причины компания нашла не сразу. OpenAI в том же году откатила обновление GPT-4o, после которого модель начала поддакивать всему подряд. Имя модели при этом не менялось ни разу.
Поэтому спорить о том, понерфили или нет, без своей базы бессмысленно. Я решил проверить на своей.
Повтор: модель не поглупела
Те же пять задач, те же промпты, та же настройка размышлений (OpenAI называет её effort, у Sol четыре уровня: low, medium, high, xhigh). Каждую задачу четыре раза.
В четырёх задачах с расчётами 16 верных ответов из 16, как и неделю назад. Двойная оплата коробок найдена, латинская «C» в артикуле найдена, выход из договора без штрафа найден, прибыль с пледа 570,80 ₽ до копейки.
Изменилось две вещи. Модель стала отвечать быстрее: задача с прибылью неделю назад занимала 12 секунд, сегодня 8. Сотрудник OpenAI 2 октября написал, что у Sol был «медленный старт» из-за наплыва пользователей в первые два дня, и всем платным аккаунтам сбросили лимиты в качестве извинения. И модель стала думать меньше: в той же задаче на размышления уходило в среднем 186 служебных токенов, сегодня 126. На ответах это не сказалось.
Если смотреть только на расчёты, модель за неделю не изменилась. Вопрос в задаче с отзывами, где результат прыгает.
Что на самом деле меняет ответ
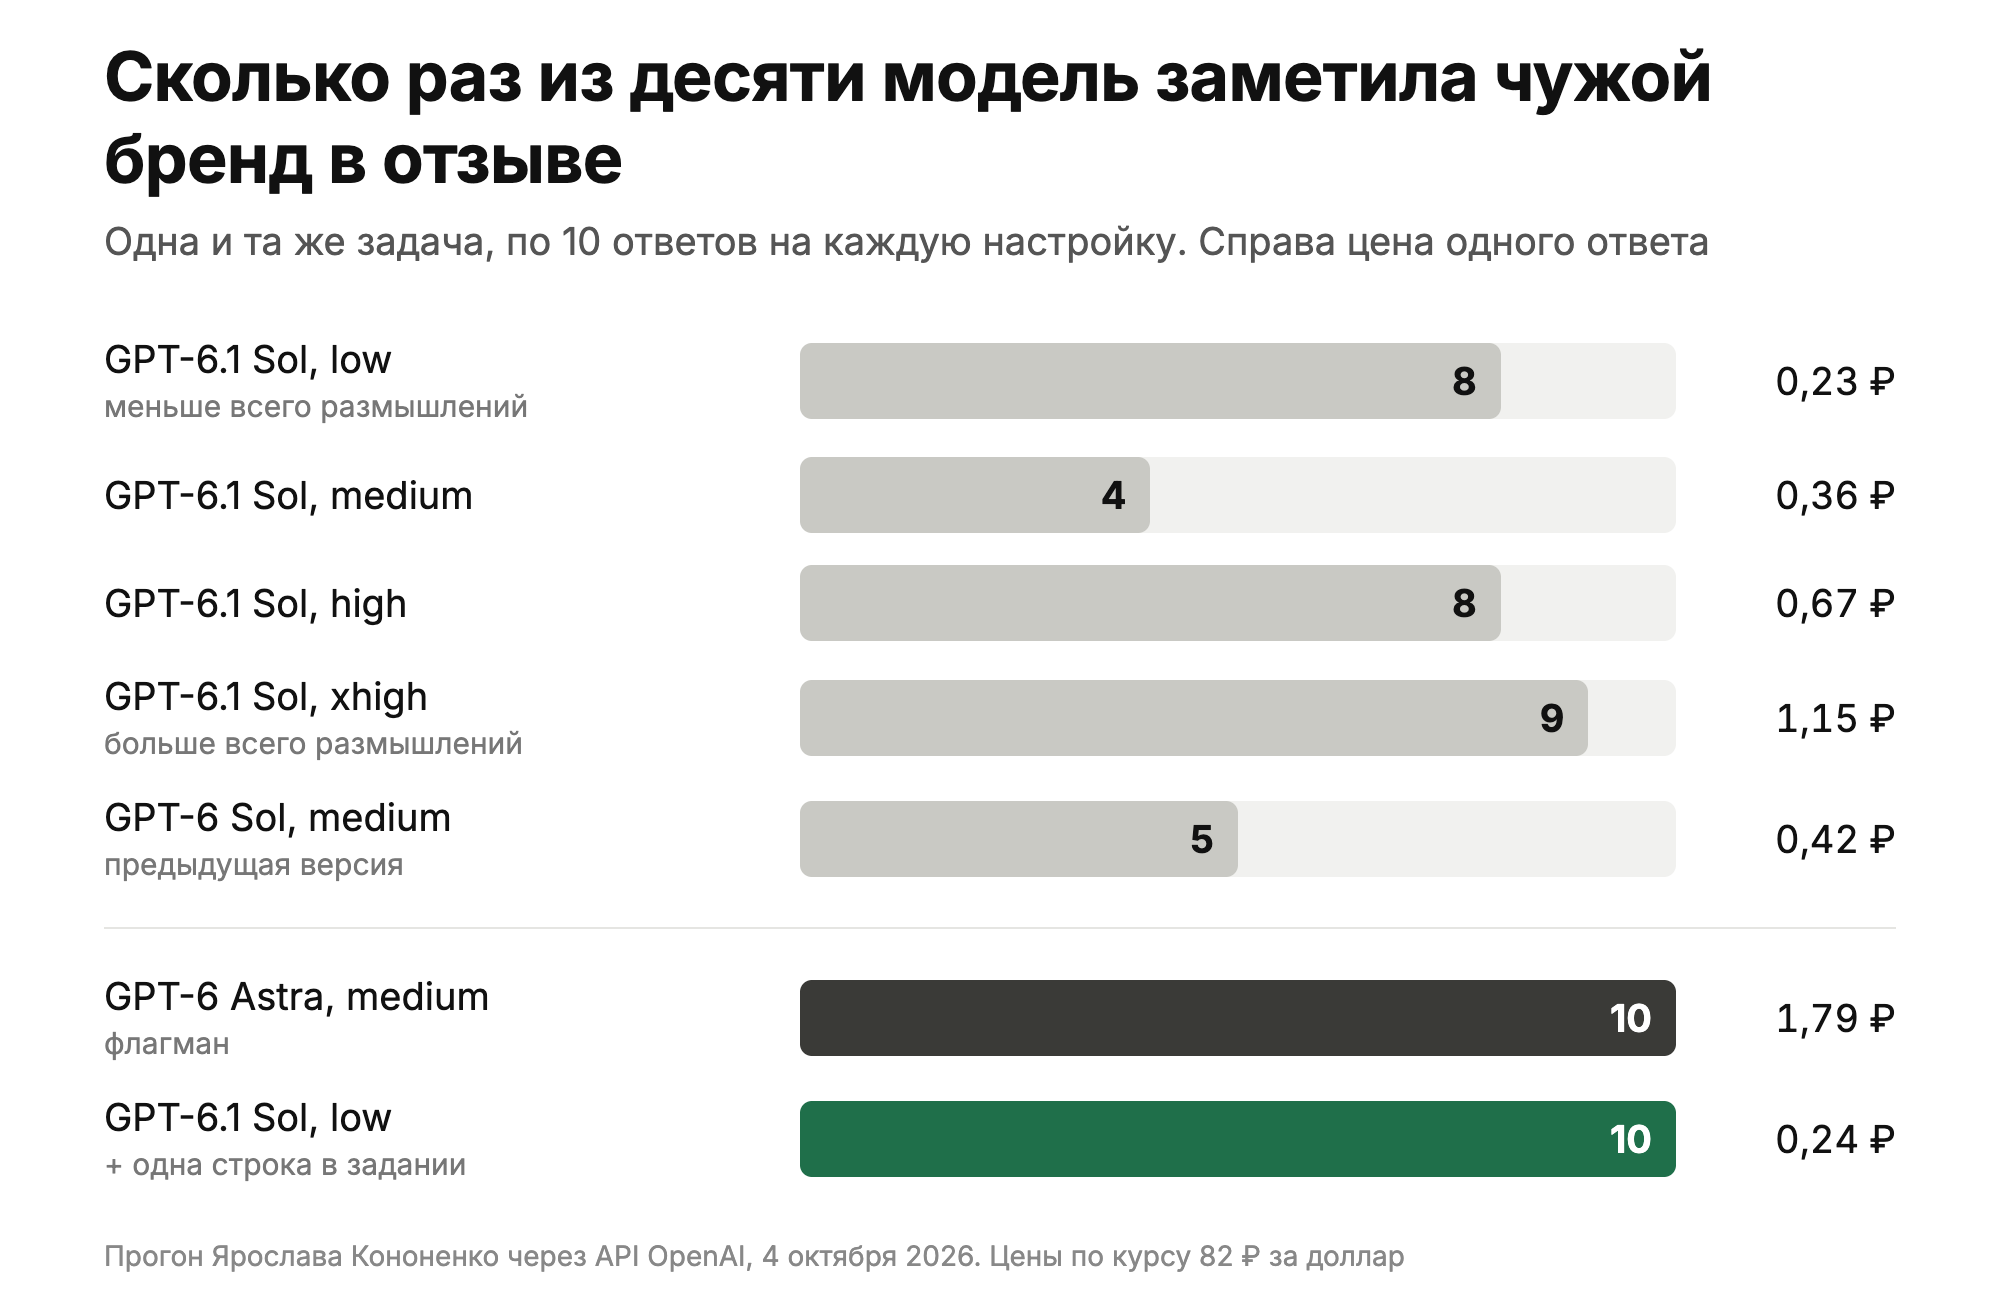
Задачу с отзывами я прогнал 70 раз: новая Sol на всех четырёх уровнях размышлений, флагман GPT-6 Astra, предыдущая Sol и ещё один вариант, о котором ниже. По десять ответов на каждую настройку.
| Настройка | Заметила чужой бренд | Цена ответа |
|---|---|---|
| GPT-6.1 Sol, low | 8 из 10 | 0,23 ₽ |
| GPT-6.1 Sol, medium | 4 из 10 | 0,36 ₽ |
| GPT-6.1 Sol, high | 8 из 10 | 0,67 ₽ |
| GPT-6.1 Sol, xhigh | 9 из 10 | 1,15 ₽ |
| GPT-6 Sol (предыдущая), medium | 5 из 10 | 0,42 ₽ |
| GPT-6 Astra (флагман), medium | 10 из 10 | 1,79 ₽ |
| GPT-6.1 Sol, low + одна строка в задании | 10 из 10 | 0,24 ₽ |
Цены пересчитаны из долларов по курсу 82 ₽.
Первое, что я не ожидал увидеть: самая дешёвая настройка справилась вдвое лучше средней. Восемь из десяти на low и четыре из десяти на medium. Я не думаю, что medium хуже по устройству: десять ответов это мало, и разница может быть случайной. Но из этого следует неприятная вещь. Если бы неделю назад я проверял модель на low, а сегодня кто-то переключил её на medium, я бы честно написал «понерфили».
Второе. Думать дольше помогает, но дорого. На xhigh модель размышляла в среднем над тысячей служебных токенов против сорока на low, отвечала 27 секунд вместо шести и стоила впятеро дороже. Результат девять из десяти.
Третье. Последняя строка таблицы: та же самая дешёвая настройка, но в задании одна фраза: «Перед ответом на каждый отзыв сверь, о нашем ли товаре и бренде в нём речь». Десять из десяти, 0,24 ₽ за ответ. Столько же, сколько у флагмана, в семь раз дешевле.
Вот как выглядит разница на одном отзыве. Medium без подсказки: «Приносим извинения за повреждение пледа и отсутствие ответа на сообщения. Пожалуйста, оформите заявку на возврат через WB». Low с одной строкой: «Вы указали Sleepy Cloud, наш бренд „Домашний уют“. Пожалуйста, проверьте продавца в заказе».
Ручки, которых вы не видите
Когда я готовил прогон, выяснилась ещё одна деталь. Температуру, которой раньше управляли случайностью ответа, у этой модели выставить нельзя совсем: API отвечает «temperature is not supported with this model». Уровней размышлений четыре, нижних вариантов «без размышлений» нет. Это настройки, которые провайдер оставил открытыми. Остальные он держит у себя.
В приложении ChatGPT не видно и этих. Уровень размышлений подбирается за вас, системный промпт меняется без объявлений, длинный разговор сжимается, и что из него выкинуто, вы не знаете. Модель с тем же названием в приложении в понедельник и в пятницу может работать с разными настройками, и пользователь назовёт это «понерфили», хотя веса никто не трогал.
Я делаю ИИ-агента, который работает в кабинетах маркетплейсов, и моя главная поправка к собственной картине мира за эту неделю такая: модель перестала быть главной переменной. Разница между флагманом и дешёвой моделью в моей задаче уместилась в одну фразу задания. Разница между двумя уровнями размышлений одной модели оказалась больше, чем между двумя её версиями. То, что вокруг модели (инструкция, проверка, настройки, порядок шагов), решает больше, чем строчка с её названием.
При этом флагман свои деньги отрабатывает: он заметил подвох без всякой подсказки десять раз из десяти. Подсказка работает только для подвоха, о котором вы знаете заранее. Про неизвестный подвох дешёвой модели никто не напишет строку.
Как проверить свою модель, а не спорить в ленте
Пять задач из своей работы с заранее известным ответом. Хотя бы в одной подвох, о котором в условии не сказано. Каждую прогнать не два раза, а десять: на двух я неделю назад сделал неверный вывод. Записать, с какими настройками гоняли. Повторить после каждого релиза и каждого «кажется, она стала тупее».
Весь мой прогон, 100 ответов и проверка, обошёлся примерно в сто рублей и занял полчаса. Чужой спор о нерфах в ленте стоит дороже: по нему люди меняют модель, которая на их задачах не менялась.
У нас эту роль играет агент Сам Решу: инструкции к задачам магазина в нём написаны так же, как та одна строка про бренд, а ответ покупателю перед публикацией уходит человеку на подтверждение.
Похожие статьи: GPT-6.1 Sol для селлера: проверили на пяти задачах магазина на WB, Лимиты Claude и ChatGPT: почему модель дешевеет, а подписка всё теснее, Как поставить задачу ИИ-агенту: что показал эксперимент Anthropic.
Применить на практике
Подключите свои сервисы и поручите эту задачу ИИ-агенту: без ручной рутины и таблиц.